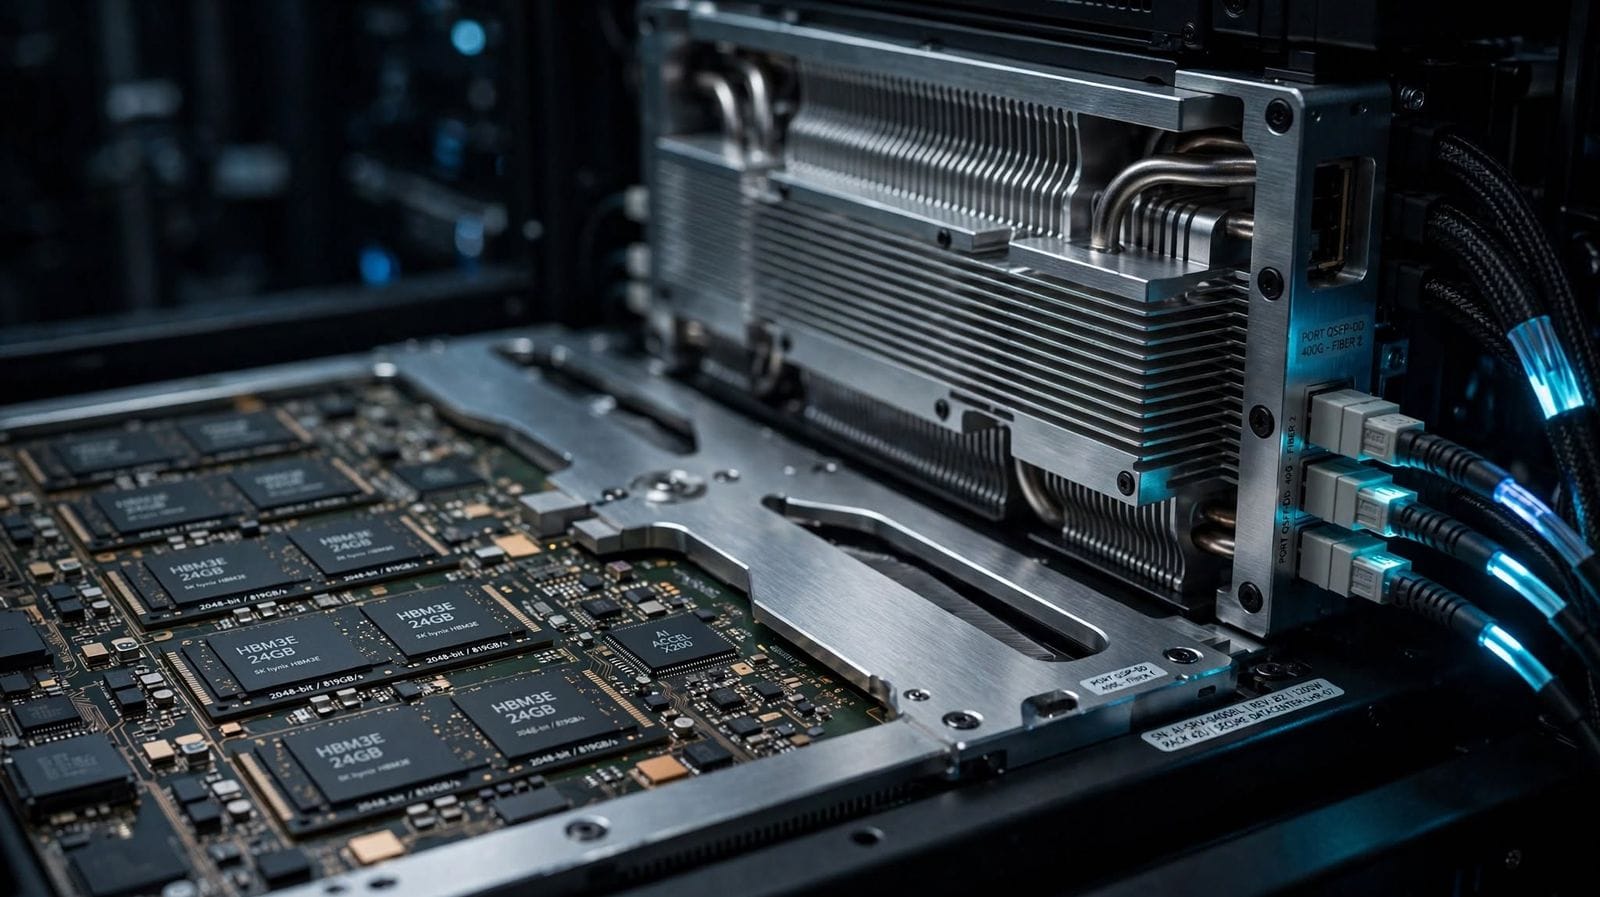
L’adozione dell’intelligenza artificiale generativa richiede spesso un’infrastruttura agile e performante. In questo contesto, implementare una vLLM API locale rappresenta una svolta per gli sviluppatori che desiderano autonomia e velocità. Questa soluzione consente di eseguire modelli linguistici avanzati direttamente sui propri server, abbattendo i costi operativi e garantendo il controllo totale sui dati riservati.
Perché scegliere vLLM per il self-hosting
La gestione efficiente della memoria rappresenta da sempre la sfida principale nell’inferenza dei modelli linguistici. Per questo motivo, il progetto adotta l’innovativo algoritmo PagedAttention, ideato per ridurre gli sprechi di memoria VRAM. Il sistema quindi riesce a gestire un numero molto più elevato di richieste contemporanee rispetto ai motori tradizionali.
Questa libreria open source disponibile su GitHub permette una perfetta compatibilità con lo standard di OpenAI. Puoi sostituire gli endpoint proprietari senza riscrivere il codice della tua applicazione esistente. Tale versatilità semplifica notevolmente il ciclo di vita del software in produzione.
Integrazione e scalabilità nell’ecosistema open source
Un ulteriore vantaggio risiede nella semplicità di integrazione con i repository di modelli. Ad esempio, è possibile scaricare e avviare istantaneamente modelli distribuiti sulla piattaforma Hugging Face, come Llama o Mistral. In questo modo la fase di prototipazione diventa rapida e snella.
Tuttavia, prima del deploy in ambienti di produzione critici, è fondamentale consultare attentamente la documentazione ufficiale di vLLM. La corretta configurazione di parametri quali il parallelismo dei tensori e la dimensione dei batch determina, infatti, le reali prestazioni del sistema.
I vantaggi concreti del throughput elevato
L’ottimizzazione dell’inferenza riduce drasticamente la latenza percepita dall’utente finale. Quindi le organizzazioni possono scalare i propri servizi intelligenti senza moltiplicare l’investimento hardware.
Infine, il passaggio a un’architettura on-premise protegge il flusso di informazioni e garantisce la conformità alle normative europee sulla privacy.
[Fonte: Tech Insider]
 sulla barra inferiore.
